すべての入力をまとめて理解
テキスト・画像・動画・音声を組み合わせ、すべての入力が同じクリエイティブ目標を支えるようにします。
テキスト・画像・音声・動画・参照素材を 1 つのブリーフにまとめて動画を作成・編集。
複数のメディア入力を 1 つのレスポンシブなクリエイティブワークフローに集約。
テキスト・画像・動画・音声を組み合わせ、すべての入力が同じクリエイティブ目標を支えるようにします。
必要なシーンに応じて、テキスト・静止画・参照素材から制作を始められます。
変更内容を平易な言葉で伝え、そのまま残すべき部分を指定します。
被写体・シーン・ビジュアルの方向性を保ちながら、既存の映像を続けて拡張します。
マルチモーダルなリクエストを 3 つの実践的なステップで構築。
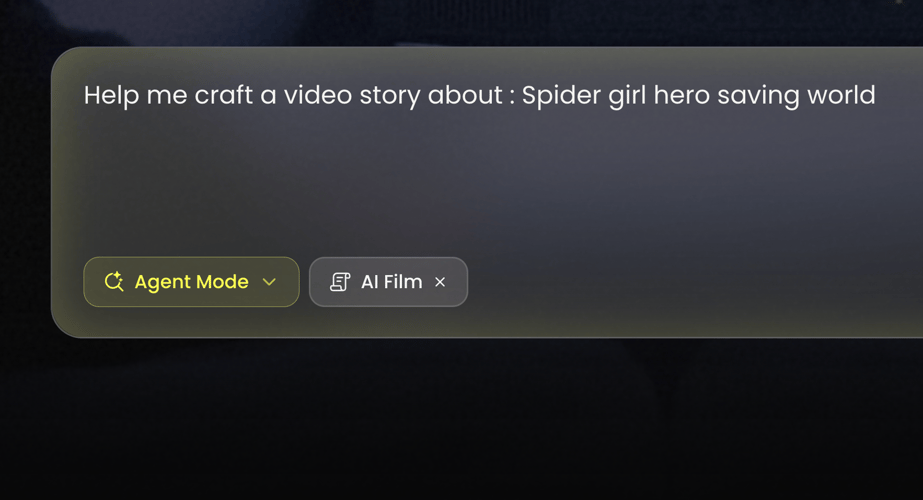 ステップ 01
利用可能な場合は Buzzy ワークスペースで Gemini Omni Flash を選択します。
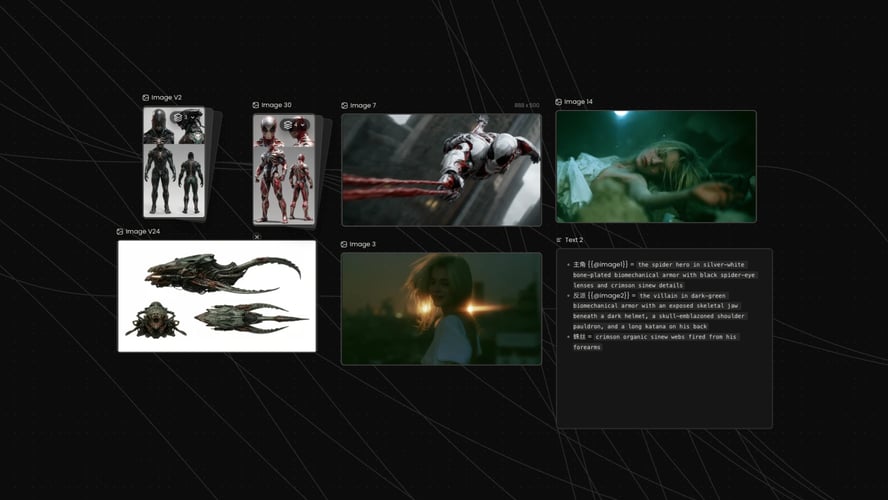 ステップ 02
指示を直接的な言葉で書きます。現在の素材、望む変更、意図する結果を明記してください。
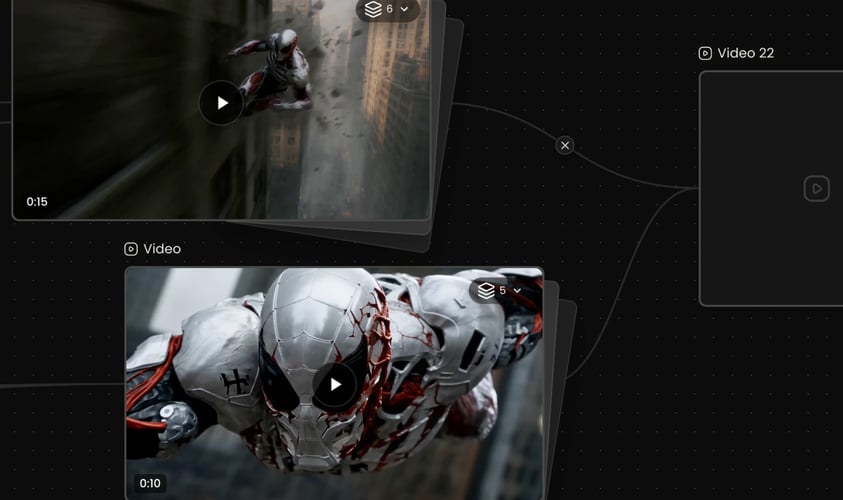 ステップ 03
Buzzy に表示される有効な設定を選んで結果を作成し、完成したシーケンス全体を確認します。
Buzzy
各アセットがなぜ存在するのかをモデルに伝えます。
ブレてはいけない要素を明記します。製品なら形状・素材・ラベルの配置・色を保持します。
時間の経過に沿って何が起きるかを記述します。開始状態、アクション、カメラの動き、最終状態を説明してください。
目的を達成する最小限の変更を定義します。
Gemini Omni はクリエイティブな生成と Gemini の知識・推論を組み合わせるよう設計されています。
各結果を次の指示のコンテキストとして活用します。
Buzzy ワークスペースに表示される選択肢に従って、アスペクト比と出力設定を選びます。
サウンド付きで結果全体を視聴します。
元のクリップと的確な変更リクエストから始めます。
製品画像・ブランド参照素材・既存のキャンペーンクリップを使ってビジュアルの軸を定めます。
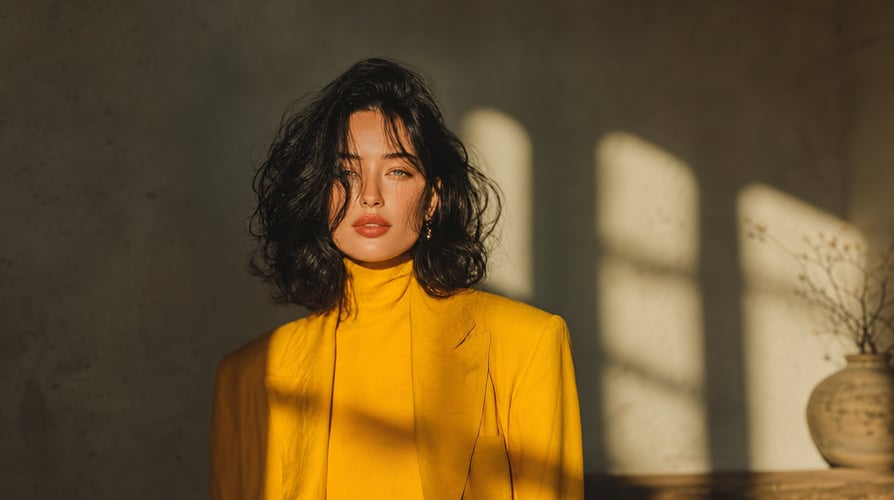
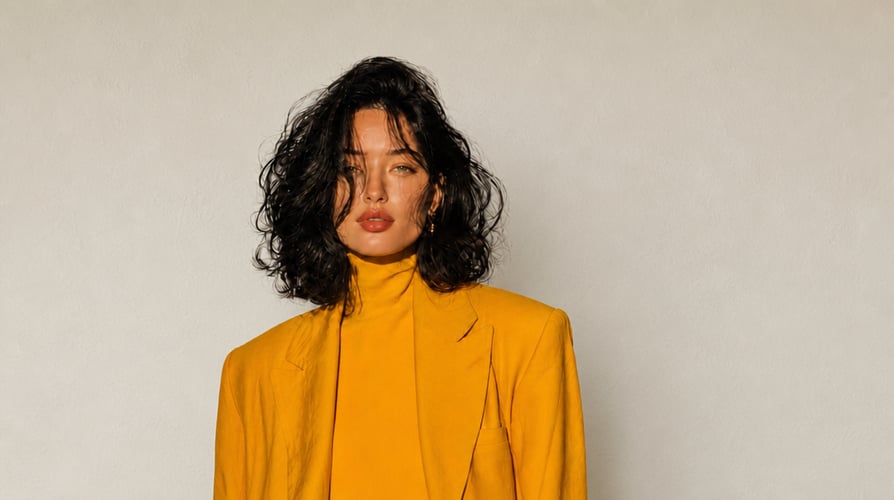
最初のフレーム・被写体・アートディレクションがすでにある場合に画像を活用します。
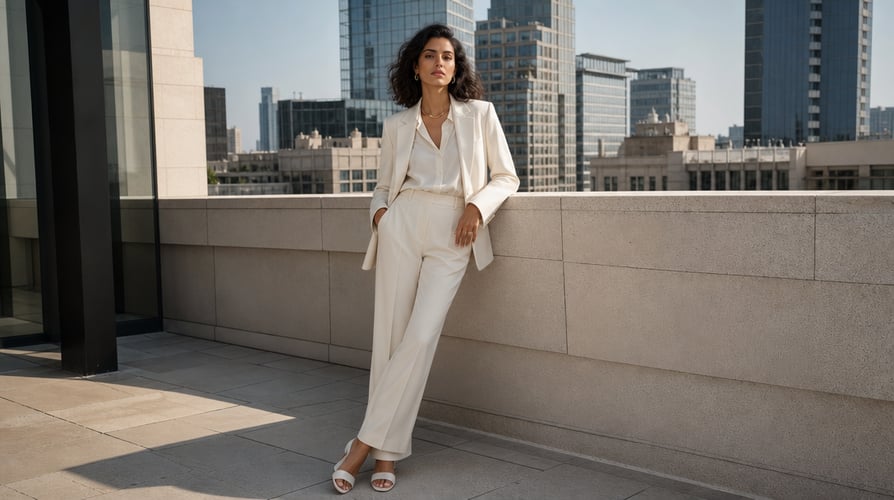
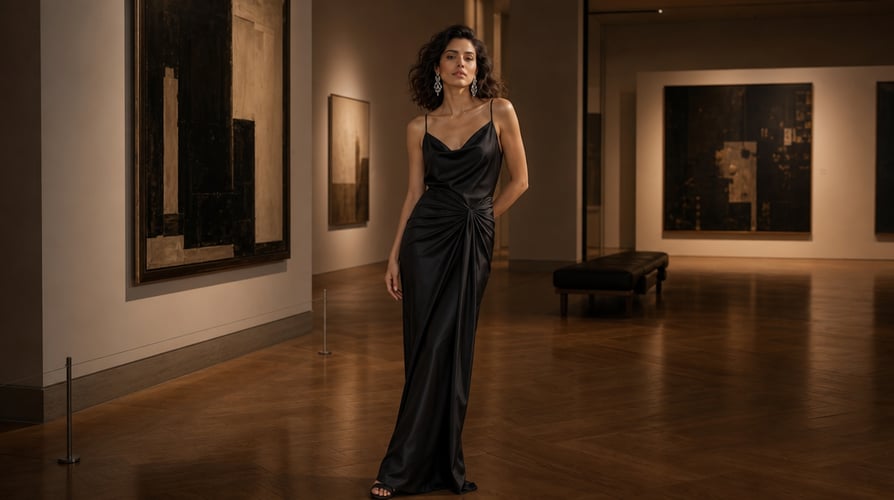
クリップを現在の終わりから先へ続けたり、同じ世界観で別のシーンを作ったり、既存素材を文脈として新しいビジュアル表現を試したりします。
Buzzy は画像・動画・クリエイティブエージェントのワークフローを 1 つに統合します。
Gemini Omni Flash についてよくある質問への回答。
Gemini Omni Flash は Google の Gemini Omni ファミリーに属するモデルで、マルチモーダルな推論・生成・動画編集を組み合わせています。
Buzzy ワークスペースで利用可能なときにモデルを選び、タスクを選択し、関連するメディアを追加して、残すものと変えるものを記述します。
はい。Gemini Omni は自然な段階的動画編集のために設計されています。元の素材を用意し、目に見える変更を平易な言葉で記述してください。
このモデルファミリーはテキスト・画像・動画・音声にまたがって処理できます。参照素材を使って動画制作を導くこともできます。
Gemini Omni システムは画像から動画への生成に対応しています。画像で最初の構図や被写体を定め、動き・カメラの挙動・シーンの展開・最終状態を記述してください。
はい、参照素材から動画への生成は Gemini Omni の対応する制作モードの 1 つです。参照素材は被写体のアイデンティティ・シーン・ビジュアルの方向性を導けます。
元素材・保持要件・要求する変更・意図する結果を明確にします。
Buzzy は現在のアクセス状況・クレジット要件・モデルの利用可否を有効なワークスペースに表示します。これらの条件は変わることがあるため、インターフェースが信頼できる情報源です。
テキスト・画像・動画・音声・参照素材を 1 つのクリエイティブな対話にまとめましょう。Gemini Omni Flash はネイティブなマルチモーダル理解を軸に設計されているため、動画タスクはプロンプト以上のものから始められます。新しいシーンを記述したり、視覚的な文脈を与えたり、既存の映像を続けたり、クリエイティブな目的を明確に保ちながら特定の編集をリクエストしたりできます。 Buzzy では、ワークフローは完了させたいジョブから始まります。関連する入力を選び、何を残し何を変えるかを説明し、生成された結果をつながりのあるビジュアルシーケンスとして確認します。Gemini Omni Flash は、ブリーフがメディアの種類をまたぐ場合や、知識・推論・編集を連携させる必要がある場合に役立ちます。
マルチモーダルなブリーフには、既存の素材と要求する成果を 1 か所にまとめられます。タスクを説明するにはテキストを、被写体やスタイルを定めるには画像を、動きやシーンの文脈を与えるには動画を、サウンドが編集や生成に影響する場合は音声を使います。Gemini Omni Flash は各メディアを無関係なステップとして扱うのではなく、これらの入力を横断して推論できます。
シーンがまだ存在しない場合はテキストから始めます。構図や被写体が結果を導くべき場合は画像から始めます。アイデンティティ・環境・ビジュアル言語により強い一貫性が必要な場合は参照素材を使います。Gemini Omni Flash は、より広範な Gemini Omni システムの中で、テキストから動画、画像から動画、参照素材から動画へのタスクに対応します。
複雑なタイムラインツールを覚える代わりに、目に見える変更を記述します。シーンを変えたり、要素を更新したり、ビジュアル表現を変えたり、段階的な対話でシーケンスを再構成したりをリクエストできます。Gemini Omni Flash は自然な動画編集のために設計されており、手作業のマスキングやフレーム単位の操作ではなく、クリエイティブな判断にリクエストを集中させられます。
既存の動画や視覚的な文脈を使って、次に何が起きるかを探ります。シーンの拡張は、元のクリップがアクションの決着前に終わる場合、環境にもっと余白が必要な場合、シーケンスにつながりのある継続が必要な場合に役立ちます。安定して残すべき要素を明記し、新しい展開を説明することで、拡張部分が同じビジュアル世界に属するようにします。
利用可能な場合は Buzzy ワークスペースで Gemini Omni Flash を選択します。新しい動画を生成するのか、画像をアニメーション化するのか、参照素材を使うのか、映像を編集するのか、シーンを拡張するのかを決めます。そのジョブを支えるメディアだけを追加します。プロンプトを書く前に、譲れない要素、すなわち被写体のアイデンティティ・製品の見た目・環境・タイミング・音声・最終的な構図を特定しておきます。
指示は直接的な言葉で書きます。現在の素材、望む変更、意図する結果を明記します。編集では、保持要件を変更内容から切り分けます。キャラクターとカメラアングルは保持し、背景を差し替え、ライティングを柔らかくし、最後のアクションを拡張する、といった具合です。Gemini Omni Flash は判断の階層が見えると効果を発揮します。
Buzzy に表示される有効な設定を選び、結果を作成し、完成したシーケンス全体を確認します。出力が元素材を尊重しているか、要求した変更を実行したか、一貫した動きとサウンドを保っているかを確認します。プロジェクト全体を書き直すのではなく、焦点を絞った次の指示で継続します。対話的なワークフローは、各ターンに明確な目的が 1 つあるときに最も役立ちます。
各アセットがなぜ存在するのかをモデルに伝えます。画像はキャラクターを定義し、クリップは編集対象のシーンを提供し、音声ファイルはリズムを確立し、テキストは新しいアクションを記述できます。Gemini Omni Flash は複数のモダリティを処理できますが、プロンプトはそれらの関係を明示すべきです。
ブレてはいけない要素を明記します。製品なら形状・素材・ラベルの配置・色を保持します。キャラクターなら顔・服装・特徴的な要素を保持します。編集なら、うまく機能している場合はカメラの視点やタイミングを保持します。明確な保持の指示は、要求した変更を評価しやすくします。
時間の経過に沿って何が起きるかを記述します。開始状態、アクション、カメラの動き、最終状態を説明します。動画のリクエストを静止画のプロンプトのように扱うのは避けてください。被写体・環境・編集がクリップを通して展開する場合、Gemini Omni Flash には時間的な方向づけが必要です。
目的を達成する最小限の変更を定義します。1 つのオブジェクトを差し替える、1 つのシーンを拡張する、1 つのビジュアル表現を変えることは、すべての要素を一度に書き換えるリクエストよりも確認が容易です。大きな変換は意図的に段階を踏んで行い、各結果が元素材とつながったままになるようにします。
Gemini Omni はクリエイティブな生成と Gemini の知識・推論を組み合わせるよう設計されています。これにより、ブリーフの中のオブジェクト・場所・アクション・関係をモデルが解釈しやすくなります。生成されたコンテンツは、特に正確性・安全性・ブランド表現・事実の詳細が重要な場合、依然として人によるレビューが必要です。
各結果を次の指示のコンテキストとして活用します。うまくいった部分を指し示し、残る課題を挙げ、目に見える修正をリクエストします。Gemini Omni Flash は段階的な編集のために作られているため、制御された一連のプロンプトは、1 つの巨大な指示よりも効果的です。
Buzzy ワークスペースに表示される選択肢に従って、アスペクト比と出力設定を選びます。最終的な用途に合わせて被写体の位置を計画します。縦型のソーシャルクリップはモバイルで安全なタイトなフレーミングが必要で、横型のシーケンスはより多くの環境とカメラの動きを見せられます。
サウンド付きで結果全体を視聴します。連続性、意図しないオブジェクトの変化、アイデンティティのブレ、トランジションの品質、編集の境界、そして最終フレームが意図した用途を支えているかを確認します。技術的に成功した生成が、自動的に完成したクリエイティブアセットになるわけではありません。
元のクリップと的確な変更リクエストから始めます。目に見える要素を削除または差し替えたり、雰囲気を調整したり、シーンの表現を見直したり、特定の瞬間を再構成したりします。指示は目に見えて確認できるものに結びつけておきます。自然な編集は、望む違いが具体的なときに最も効果を発揮します。
製品画像・ブランド参照素材・既存のキャンペーンクリップを使ってビジュアルの軸を定めます。次に、新しいコンセプトに必要なシーン・アクション・カメラ・変換を記述します。Gemini Omni Flash は参照素材と記述された指示を横断して推論でき、ブリーフに一貫した出発点を与えます。
最初のフレーム・被写体・アートディレクションがすでにある場合に画像を活用します。シーンがどう動くべきか、カメラが何を映すべきか、アクションがどこで終わるべきかを説明します。参照素材はアイデンティティやスタイルを明確にする場合にのみ追加します。画像から動画への生成は、すでに見えているものを繰り返すのではなく、プロンプトが展開を記述するときに最も効果を発揮します。
クリップを現在の終わりから先へ続けたり、同じ世界観で別のシーンを作ったり、既存素材を文脈として新しいビジュアル表現を試したりします。Gemini Omni Flash はシーンの拡張とマルチモーダルな推論を支援でき、クリエイターが元のコンセプトを手放すことなくバリエーションを探るのに役立ちます。
Gemini Omni Flash は Google の Gemini Omni ファミリーに属するモデルで、マルチモーダルな推論・生成・動画編集を組み合わせています。テキスト・画像・動画・音声・参照素材を扱うことができ、新しい動画の生成、画像から動画、参照素材から動画、編集、シーンの拡張などのタスクに対応します。
Buzzy ワークスペースで利用可能なときにモデルを選び、タスクを選択し、関連するメディアを追加して、残すものと変えるものを記述します。結果を生成し、元素材とブリーフに照らして確認したら、焦点を絞った次の指示で継続します。
はい。Gemini Omni は自然で段階的な動画編集のために設計されています。元の素材を用意し、目に見える変更を平易な言葉で記述します。範囲を明確に保ち、結果を確認し、そうすることで成果を制御しやすくなる場合は追加の変更を別のパスで扱います。
このモデルファミリーはテキスト・画像・動画・音声にまたがって処理できます。参照素材を使って動画制作を導くこともできます。Buzzy のワークフローでは、有効なモデルに現在表示されている入力オプションのみを使い、アップロードしたすべてのアセットの役割を説明してください。
Gemini Omni システムは画像から動画への生成に対応しています。画像で最初の構図や被写体を定め、動き・カメラの挙動・シーンの展開・最終状態を記述します。画像だけから意図したアクションをモデルが推測できると想定しないでください。
はい、参照素材から動画への生成は、対応する Gemini Omni の制作モードの 1 つです。参照素材は被写体のアイデンティティ・シーン・ビジュアルの方向性を導けます。一貫したアセットのセットを使い、各参照素材の優先度をプロンプトで明示してください。
元素材・保持要件・要求する変更・意図する結果を明確にします。たとえば、キャラクターとカメラの動線を保持し、背景を雨の夜の街路に差し替え、最後の歩行を数拍分延ばす、といった具合です。具体的な指示は「もっと良くして」のような漠然としたリクエストよりも評価しやすくなります。
Buzzy は現在のアクセス状況・クレジット要件・モデルの利用可否を有効なワークスペースに表示します。これらの条件は変わることがあるため、インターフェースが信頼できる情報源です。ランディングページの一文をもとに、恒久的な無料枠や固定の利用量を想定しないでください。
1 つのマルチモーダルタスクを選び、それを支える入力だけを追加し、元素材と要求する出力との関係を説明します。